메신저 답장, 커밋 메시지, 이슈 코멘트처럼 짧은 글을 하루에도 수십 번 타이핑한다. 말로 하면 빠른데, OS 내장 받아쓰기는 플랫폼마다 다르고 리눅스에는 아예 없다. 클라우드 음성 인식 서비스는 음성을 외부로 보내야 하고 대부분 유료다. Handy는 단축키를 누르고 말하면 로컬 모델로 전사해 지금 커서가 있는 입력창에 붙여 넣어 주는 오픈소스 데스크톱 앱이다. 음성은 컴퓨터 밖으로 나가지 않는다. 이 글에서는 Ubuntu 24.04에 Handy 0.9.8을 설치하고, 명령줄 전사 모드로 영어·한국어 모델을 실측 비교한 뒤, 단축키 연동과 리눅스에서 걸리는 지점을 정리한다.
Handy 개요
| 항목 | 내용 |
|---|---|
| 동작 | 단축키 누름 → 녹음 → 놓음 → 로컬 전사 → 활성 창에 붙여 넣기 |
| 플랫폼 | Linux(deb/rpm/AppImage, x86_64·aarch64), macOS, Windows |
| 구조 | Tauri 2(Rust 백엔드 + TypeScript 프런트엔드). 전사 엔진은 transcribe-cpp(GGUF/ggml)와 transcribe-rs(ONNX) |
| 모델 | 카탈로그 69개. Parakeet, Whisper, Moonshine, SenseVoice, Qwen3-ASR, Canary, Voxtral 등 |
| 음성 구간 검출 | Silero VAD(기본), 실험적 earshot |
| 라이선스 | MIT. 단, Handy 이름·로고 등 브랜드 자산은 제외 |
| 버전 | 0.9.8(2026-10-03 릴리스) 기준 |
설정 창은 일반·히스토리·모델·고급·정보 다섯 탭이고, 시스템 로캘에 맞춰 한국어 UI로 뜬다.
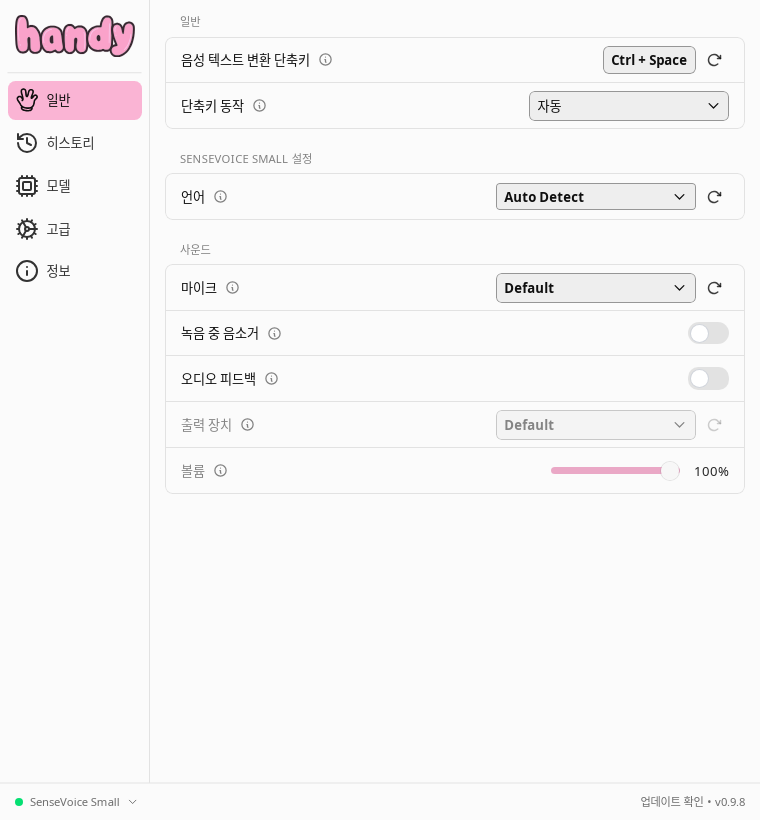
리눅스 기본 단축키와 녹음 관련 기본값은 설치 직후 생성된 settings_store.json에서 확인한 값이다.
| 설정 | 기본값 | 의미 |
|---|---|---|
transcribe | ctrl+space | 전사 |
transcribe_with_post_process | ctrl+shift+space | 전사 후 LLM 후처리 |
cancel | escape | 녹음 취소 |
shortcut_activation | hold_or_toggle | 누르고 있으면 push-to-talk, 짧게 누르면 토글 |
paste_method | direct | 키 입력 도구로 직접 입력. ctrl_v/shift_insert/none 등 선택 가능 |
filler_word_removal_enabled | true | “um”, “uh” 같은 군말 제거 |
history_limit | 5 | 보관하는 전사 기록 수 |
model_unload_timeout | min5 | 5분 미사용 시 모델 언로드 |
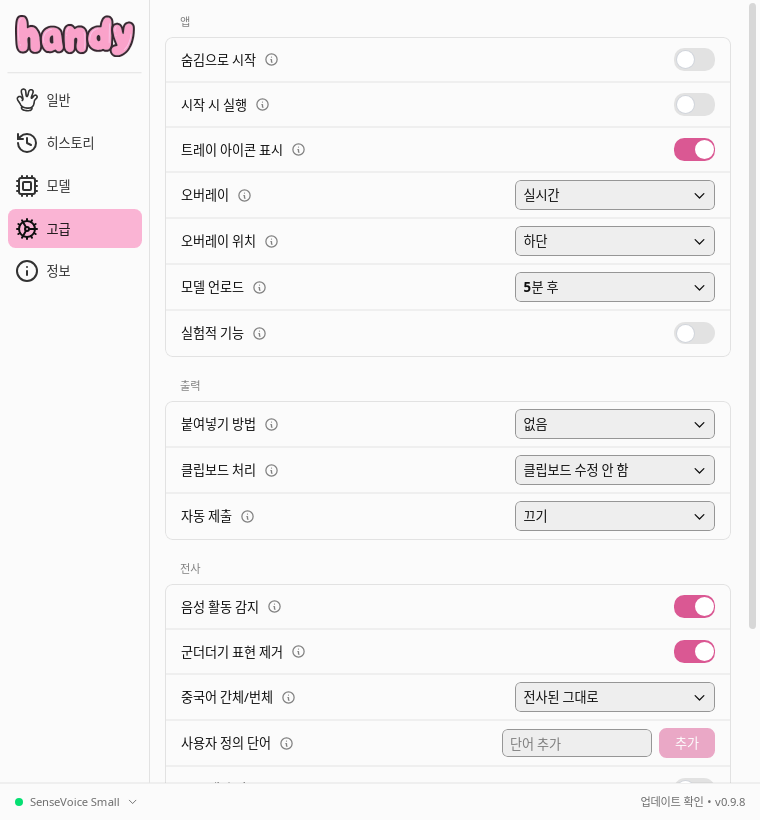
붙여넣기 방법, 오버레이, 음성 활동 감지, 군더더기 제거, 사용자 정의 단어는 고급 탭에 모여 있다. 아래 화면은 실습용으로 붙여넣기 방법을 “없음”으로 바꾼 상태다.
Ubuntu에 설치
deb는 의존성 해결을 위해 dpkg -i가 아니라 apt install로 설치한다.
curl -sSLO https://github.com/cjpais/Handy/releases/download/v0.9.8/Handy_0.9.8_amd64.deb
dpkg-deb -f Handy_0.9.8_amd64.deb Package Version Depends
sudo apt install ./Handy_0.9.8_amd64.deb
handy --help
Package: handy
Version: 0.9.8
Depends: libgtk-layer-shell0, libopenblas0, libappindicator3-1, libwebkit2gtk-4.1-0, libgtk-3-0
...
Usage: handy [OPTIONS]
Options:
--start-hidden Start with the main window hidden
--no-tray Disable the system tray icon
--toggle-transcription Toggle transcription on/off (sent to running instance)
--toggle-post-process Toggle transcription with post-processing on/off (sent to running instance)
--cancel Cancel the current operation (sent to running instance)
--debug Enable debug mode with verbose logging
-f, --transcribe-file <WAV> Transcribe this WAV (16 kHz mono) headlessly and exit. ...
--model <MODEL> Model id to load for --transcribe-file (default: the selected model)
--device-index <N> Hard-select the compute device for --transcribe-file ...
--list-devices List the transcribe-cpp compute devices (with indices) and exit
--list-models List the available models (with ids) and exit. ...
--repeat <N> Repeat the transcription N times (best_ms reports the fastest run)
--json Emit --transcribe-file results as JSON
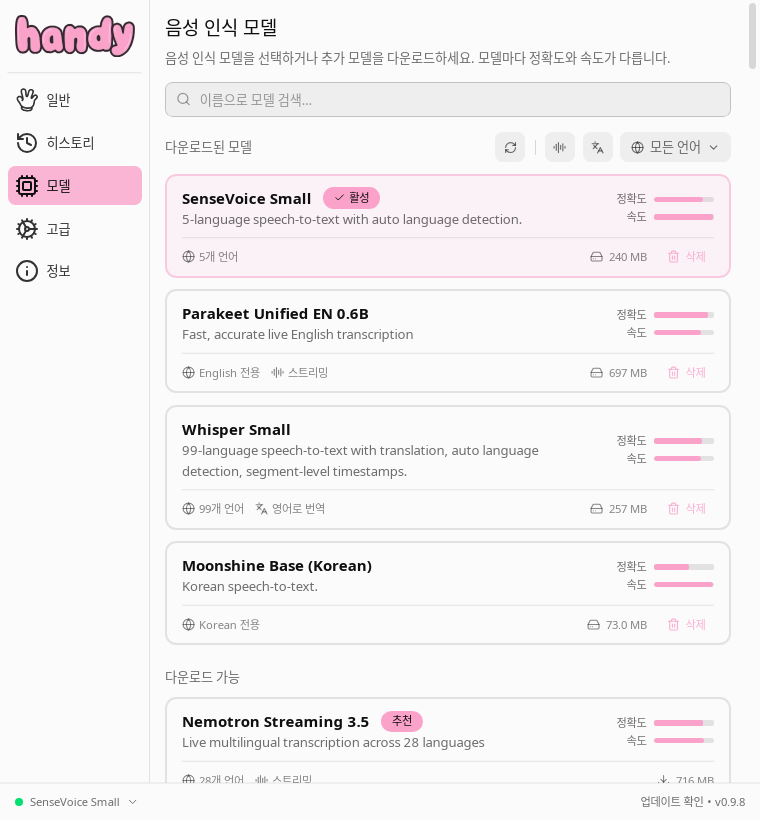
-h, --help Print help처음 실행하면 모델 선택 화면이 뜨고, 하나를 골라 내려받으면 바로 쓸 수 있다. 상단 두 개가 추천 모델인데 1순위는 “English 전용”이라는 점에 주의한다.
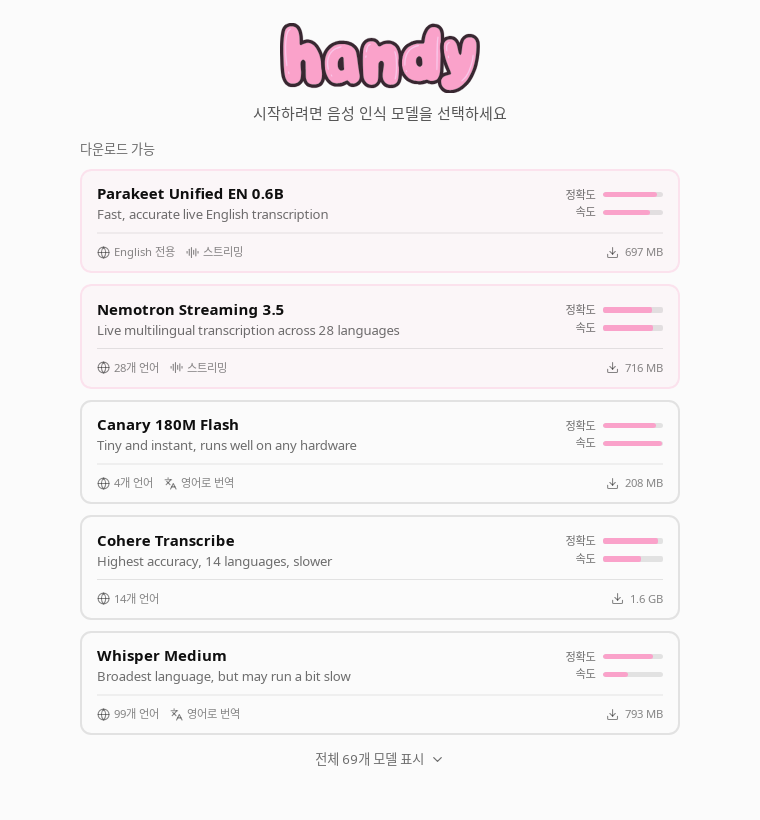
이하 실습은 SSH로 접속한 Ubuntu 24.04 VM(AMD Ryzen 5 7600, vCPU 6개, GPU 없음)에서 진행했고, 화면은 Xvfb 가상 디스플레이에서 캡처했다.
모델 선택
--list-models는 카탈로그 전체를 모델 ID와 함께 출력한다. 화면이 없는 SSH 세션이라 xvfb-run으로 감쌌다(이유는 주의사항 참고).
xvfb-run -a handy --list-models 2>&1 | grep -v INFO | head -8Available models (✓ = installed):
handy-computer/parakeet-unified-en-0.6b-gguf/parakeet-unified-en-0.6b-Q8_0.gguf Parakeet Unified EN 0.6B [recommended]
handy-computer/nemotron-3.5-asr-streaming-0.6b-gguf/nemotron-3.5-asr-streaming-0.6b-Q8_0.gguf Nemotron Streaming 3.5 [recommended]
handy-computer/canary-180m-flash-gguf/canary-180m-flash-Q8_0.gguf Canary 180M Flash [recommended]
handy-computer/cohere-transcribe-03-2026-gguf/cohere-transcribe-03-2026-Q5_K_M.gguf Cohere Transcribe [recommended]
handy-computer/whisper-medium-gguf/whisper-medium-Q8_0.gguf Whisper Medium [recommended]
handy-computer/Voxtral-Mini-4B-Realtime-2602-gguf/Voxtral-Mini-4B-Realtime-2602-Q5_K_M.gguf Voxtral Mini 4B Realtime
...카탈로그(src-tauri/src/catalog/catalog.json)의 메타데이터로 추천 모델과 한국어 지원 모델을 추리면 다음과 같다. 크기는 기본 양자화 파일 기준이다.
| 모델 | 파라미터 | 크기 | 언어 수 | 한국어 | 스트리밍 |
|---|---|---|---|---|---|
| Parakeet Unified EN 0.6B(추천 1순위) | 0.6B | 731MB | 1 | X | O |
| Nemotron Streaming 3.5(추천 2순위) | 0.6B | 751MB | 28 | O | O |
| Cohere Transcribe | 2.0B | 1,770MB | 14 | O | X |
| Whisper Small / Medium / Large v3 Turbo | 242M / 764M / 809M | 270 / 832 / 886MB | 99~100 | O | X |
| Qwen3-ASR 0.6B | 782M | 850MB | 30 | O | X |
| SenseVoice Small | 234M | 253MB | 5 | O | X |
| Moonshine Base (Korean) | 62M | 77MB | 1 | O | X |
프록시 환경 등에서 수동으로 받을 때는 앱 데이터 디렉터리의 models/에 파일명 그대로 두면 재시작 후 인식된다. 앱 데이터 디렉터리는 정보 탭에 표시된다.
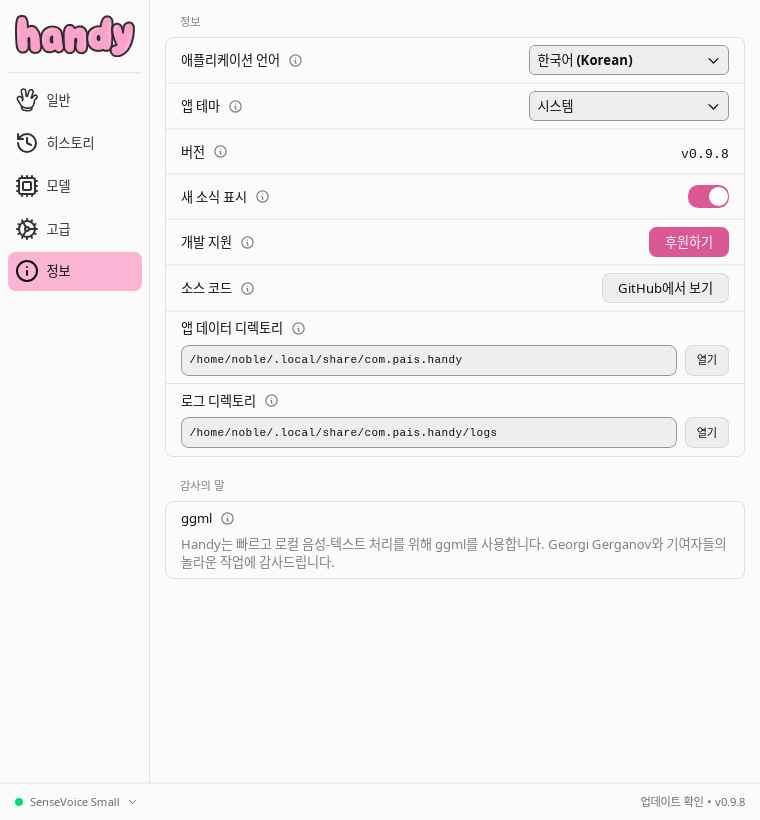
다운로드 URL은 카탈로그의 {mirror}/{id}/{revision}/{filename} 형식이다.
cd ~/.local/share/com.pais.handy/models
B=https://blob.handy.computer/handy-computer
curl -sSfLO $B/parakeet-unified-en-0.6b-gguf/7e948f21b7bdbac698d3318db9d350f1096f3b6c/parakeet-unified-en-0.6b-Q8_0.gguf
curl -sSfLO $B/whisper-small-gguf/c0214bd34be9296695486f838e0142f900803159/whisper-small-Q8_0.gguf
curl -sSfLO $B/moonshine-base-gguf/3ef112378a8cf46ac8b278d9bfa2d15c846704b8/moonshine-base-Q8_0.gguf
curl -sSfLO $B/moonshine-base-ko-gguf/03813c71abe85b40cd0671d3cfa420e831d7e333/moonshine-base-ko-Q8_0.gguf
curl -sSfLO $B/SenseVoiceSmall-gguf/4a08b8e900b38a977e32eb08d5d0697d6e72ba04/SenseVoiceSmall-Q8_0.gguf
sha256sum *.gguf
b430672cfdde98b894bd98adf1a8b3470308fea39ad1e6bb0f54d8fc9e114471 moonshine-base-ko-Q8_0.gguf
7f0027dfd857d310b63a85ef57cadf183da712cc374f85a648f8bc18aaa2efc8 moonshine-base-Q8_0.gguf
4b50b6dd862bf6e346929aaf4f5eaacec003bfa3f56462d6c874b41ef2f38795 parakeet-unified-en-0.6b-Q8_0.gguf
6c759ee4c9748c9b3f7a5a60ca74f0f7e685fb9d45d1378fce7cfd62f59adf29 SenseVoiceSmall-Q8_0.gguf
9b9c8811bbcc82a7766f0fb0925614bdacb0923b2cc630daeac17108b655b860 whisper-small-Q8_0.gguf해시는 카탈로그의 sha256 값과 모두 일치했다. 재시작하면 모델 탭의 “다운로드된 모델”에 나타나고, 여기서 활성 모델을 고른다.
명령줄에서 WAV 파일 전사
-f(--transcribe-file)는 앱과 같은 배치 전사 경로로 WAV를 처리하고 종료한다. 모델 비교나 스크립트 연동에 쓰기 좋다. 영어 샘플은 whisper.cpp 저장소의 jfk.wav(11초)다.
for m in handy-computer/parakeet-unified-en-0.6b-gguf/parakeet-unified-en-0.6b-Q8_0.gguf \
         handy-computer/whisper-small-gguf/whisper-small-Q8_0.gguf \
         handy-computer/moonshine-base-gguf/moonshine-base-Q8_0.gguf; do
    xvfb-run -a handy -f jfk.wav --model $m --repeat 3 2>&1 | grep -v '\]\[INFO\]'
done
model=handy-computer/parakeet-unified-en-0.6b-gguf/parakeet-unified-en-0.6b-Q8_0.gguf device=settings backend=CPU audio=11.00s load=2445ms best=3203ms rtf=3.43x
text: And so, my fellow Americans, ask not what your country can do for you. Ask what you can do for your country.
model=handy-computer/whisper-small-gguf/whisper-small-Q8_0.gguf device=settings backend=CPU audio=11.00s load=172ms best=7641ms rtf=1.44x
text: And so my fellow Americans, ask not what your country can do for you, ask what you can do for your country.
model=handy-computer/moonshine-base-gguf/moonshine-base-Q8_0.gguf device=settings backend=CPU audio=11.00s load=76ms best=728ms rtf=15.11x
text: And so my fellow Americans ask not what your country can do for you ask what you can do for your countryrtf는 오디오 길이를 처리 시간으로 나눈 값이라 클수록 빠르다. 세 모델 모두 단어는 정확했고, Moonshine Base(77MB)는 문장부호가 없는 대신 15배 속도가 나왔다.
한국어 전사
한국어는 Google FLEURS 데이터셋(CC BY 4.0)의 실제 사람 음성을 썼다. 받은 파일이 32비트 float WAV라 그대로 넣으면 거부된다.
file ko0.wav
xvfb-run -a handy -f ko0.wav --model handy-computer/whisper-small-gguf/whisper-small-Q8_0.gguf 2>&1 | grep -v INFO; echo rc=${PIPESTATUS[0]}
ko0.wav: RIFF (little-endian) data, WAVE audio, IEEE Float, mono 16000 Hz
error: expected 16 kHz mono 16-bit PCM WAV, got 16000 Hz / 1 ch / 32-bit Float
rc=2ffmpeg로 16kHz 모노 16비트 PCM으로 변환한다.
ffmpeg -loglevel error -y -i ko0.wav -ar 16000 -ac 1 -c:a pcm_s16le ko0_s16.wav
file ko0_s16.wav
ko0_s16.wav: RIFF (little-endian) data, WAVE audio, Microsoft PCM, 16 bit, mono 16000 Hz같은 루프로 한국어 지원 모델 3개와 기본 추천 모델을 돌렸다. 정답 문장은 “다리 밑 수직 간격은 15미터이며, 공사는 2011년 8월에 마무리되었으며, 해당 다리의 통행금지는 2017년 3월까지이다.”(12.5초)와 “염소 사육은 대략 일만 년 전에 이란의 자그로스산맥에서 시작한 것으로 보입니다.”(8.9초)다.
### whisper-small-Q8_0.gguf
audio=12.48s load=185ms best=8406ms rtf=1.48x
text: 다림이 수직 간격은 15m이며 공사는 2011년 8월에 마무리되었으며 해당 다리의 통행 금지는 2017년 3월까지이다.
audio=8.94s load=179ms best=7907ms rtf=1.13x
text: 염소사육은 대략 1만 년 전에 이란의 자그로스 산맥에서 시작한 것으로 보입니다.
### moonshine-base-ko-Q8_0.gguf
audio=12.48s load=84ms best=2133ms rtf=5.85x
text: 다리 및 수직 간격은 십 오 미터이며 공사는 이천 십 일 년 팔 월에 마무리되었으며 해당 다리의 통행금지는 이천 십 칠 년 삼 월까지다
audio=8.94s load=82ms best=1228ms rtf=7.28x
text: 염소 사육은 대략 일 만 년 전에 이란을 자그로스 산맥에서 시작한 것으로 보입니다
### SenseVoiceSmall-Q8_0.gguf
audio=12.48s load=133ms best=1902ms rtf=6.56x
text: 다리미 수직 간격은 십 오 미터이며 공사는 이천 십 일 년 팔 월에 마무리되었으며 해당 다리의 통행금 이천 십칠 년 삼 월까지이다.
audio=8.94s load=128ms best=1387ms rtf=6.45x
text: 염소사육은 대략 1만년 전에 이란의 자그로스 산맥에서 시작한 것으로 보입니다.
### parakeet-unified-en-0.6b-Q8_0.gguf
audio=12.48s load=579ms best=4382ms rtf=2.85x
text: Tarimi Sujikang Yogun Shibo Mitoi Mio Kung San Itanshi Billyan Paro Bamuri Dos Mio Hetang Tare Tungen Gamjin Ichan Shi Chilian Samukajita
audio=8.94s load=819ms best=3282ms rtf=2.72x
text: Yomso Sayugun Teriak Irimanyan Jane Irane Chagaru Sisammege Sa Kangosoro Poimita
출력은 모델 ID를 줄이고 로그 줄을 뺐다. 결과를 정리하면 다음과 같다.
| 모델 | 속도(rtf) | 숫자 표기 | 오류 |
|---|---|---|---|
| Whisper Small | 1.1~1.5x | 아라비아 숫자(15m, 2011년) | “다리 밑” → “다림이” |
| Moonshine Base (Korean) | 5.9~7.3x | 한글 숫자(십 오 미터) | “밑” → “및”, “이란의” → “이란을” |
| SenseVoice Small | 6.5~6.6x | 문장마다 다름 | “다리미”, “통행금지는” 일부 누락 |
| Parakeet Unified EN(기본 추천) | 2.7~2.9x | – | 한국어를 로마자 음차로 출력 |
추천 1순위 모델은 영어 전용이라 한국어 사용자는 모델부터 바꿔야 한다. 이 CPU 환경에서는 속도를 원하면 SenseVoice, 숫자 표기와 문장부호를 원하면 Whisper가 무난하다.
JSON 출력
xvfb-run -a handy -f ko2_s16.wav --model handy-computer/SenseVoiceSmall-gguf/SenseVoiceSmall-Q8_0.gguf --json 2>/dev/null | tail -1{"audio_secs":8.94,"best_ms":1542,"bound_backend":"CPU","load_ms":136,"model":"handy-computer/SenseVoiceSmall-gguf/SenseVoiceSmall-Q8_0.gguf","requested_device":"settings","rtf":5.797665369649805,"text":"염소사육은 대략 1만년 전에 이란의 자그로스 산맥에서 시작한 것으로 보입니다.","transcribe_ms":[1542]}로그가 stderr가 아니라 stdout으로 나오므로 2>/dev/null만으로는 안 걸러지고, JSON은 마지막 줄만 잘라야 한다.
실행 중인 Handy를 명령으로 제어
Wayland에서는 앱이 전역 단축키를 직접 잡기 어려워 데스크톱 환경의 단축키에 handy --toggle-transcription을 바인딩하는 방식을 권장한다. 이 명령은 실행 중인 인스턴스에 토글 신호를 보낸다. 실제 흐름을 PipeWire 가상 마이크로 재현했다.
#!/bin/bash
# 가상 마이크: null sink를 만들고 그 monitor를 기본 입력으로
OLD_SRC=$(pactl get-default-source)
MOD=$(pactl load-module module-null-sink sink_name=vmic sink_properties=device.description=vmic)
pactl set-default-source vmic.monitor

Xvfb :99 >/dev/null 2>&1 &
export DISPLAY=:99
sleep 1
handy --start-hidden --no-tray > live.log 2>&1 &
sleep 12

# 1회차: --toggle-transcription
handy --toggle-transcription; echo "toggle#1 rc=$?"
sleep 1; paplay --device=vmic jfk.wav; sleep 1
handy --toggle-transcription; echo "toggle#2 rc=$?"
sleep 15

# 2회차: SIGUSR2
pkill -USR2 -n -x handy; sleep 1; paplay --device=vmic jfk.wav; sleep 1
pkill -USR2 -n -x handy; echo "sigusr2 sent"
sleep 15

sqlite3 -header ~/.local/share/com.pais.handy/history.db \
  "select id, datetime(timestamp,'unixepoch','localtime') ts, file_name, transcription_text
   from transcription_history order by id desc limit 3;"

pkill -x handy; pkill -x Xvfb
pactl unload-module $MOD; pactl set-default-source "$OLD_SRC"
설정에서 selected_model은 Parakeet Unified EN으로, paste_method는 붙여 넣을 창이 없으니 none으로 바꾼 뒤 실행했다.
toggle#1 rc=0
toggle#2 rc=0
sigusr2 sent
id|ts|file_name|transcription_text
2|2026-10-23 17:40:58|handy-1792777256.wav|And so, my fellow Americans, ask not what your country can do for you. Ask what you can do for your country
1|2026-10-23 17:40:26|handy-1792777222.wav|And so, my fellow Americans can do for you and what you can do for your dream right now
두 방식 모두 녹음·전사가 되고, 결과는 history.db와 recordings/의 WAV로 남는다. 시작 직후 첫 녹음(id 1)에서 단어가 빠진 문제는 주의사항에서 다룬다.
같은 방식으로 모델을 SenseVoice Small로 바꿔 한국어 샘플 2개와 jfk.wav를 녹음한 뒤 히스토리 탭을 열면 다음과 같다. 항목마다 복사, 즐겨찾기, 재전사, 삭제 버튼과 원본 녹음 재생기가 붙는다.
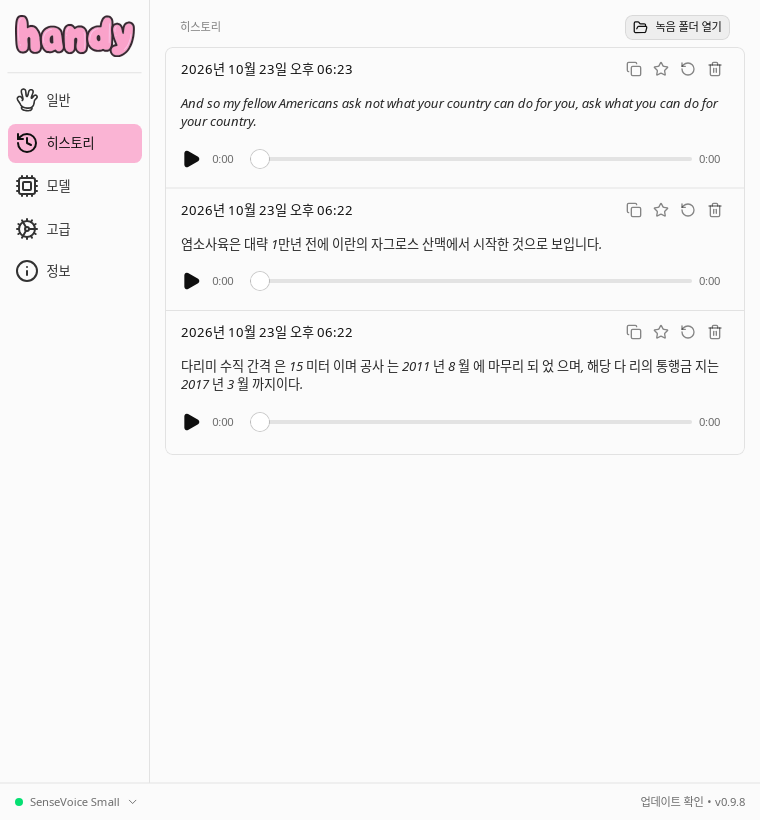
맨 아래 문장은 CLI 결과와 달리 “간격 은 15 미터 이며”처럼 띄어쓰기가 깨졌다. 앱이 저장한 녹음 파일과 원본을 -f로 다시 돌려 원인을 가렸다.
D=~/.local/share/com.pais.handy
R=$(sqlite3 $D/history.db "select file_name from transcription_history order by id desc limit 1;")
M=handy-computer/SenseVoiceSmall-gguf/SenseVoiceSmall-Q8_0.gguf
for f in $D/recordings/$R ko0_s16.wav; do
    xvfb-run -a handy -f $f --model $M 2>&1 | grep "^text"
done
text: 다리미 수직 간격 은 15 미터 이며 공사 는 2011 년 8 월 에 마무리 되 었 으며, 해당 다 리의 통행금 지는 2017 년 3 월 까지 이다.
text: 다리미 수직 간격은 십 오 미터이며 공사는 이천 십 일 년 팔 월에 마무리되었으며 해당 다리의 통행금 이천 십칠 년 삼 월까지이다.앱의 후처리가 아니라 녹음 경로(PipeWire 48kHz → 16kHz 리샘플링)를 거친 입력 자체에서 결과가 달라진다. 군더더기 제거를 꺼도 같았다.
[INFO] Live streaming transcription started (model 'handy-computer/parakeet-unified-en-0.6b-gguf/...', backend 'CPU')
[INFO] Live preview finalized in 17.76s model compute for 9.63s streamed audio (0.54x real-time): ... 107 chars
[INFO] Using paste method: None, delay before: 60ms, delay after: 60ms
[INFO] PasteMethod::None selected - skipping paste action
스트리밍 지원 모델은 녹음 중에 실시간 미리보기 전사를 돌린다. 이 VM에서는 0.5배속이라 녹음을 멈춘 뒤 결과가 나올 때까지 몇 초 더 걸렸다.
GNOME 단축키에 바인딩
K=/org/gnome/settings-daemon/plugins/media-keys/custom-keybindings/handy/
S=org.gnome.settings-daemon.plugins.media-keys
gsettings set $S custom-keybindings "['$K']"   # 기존 항목이 있으면 목록에 추가할 것
gsettings set $S.custom-keybinding:$K name "Handy"
gsettings set $S.custom-keybinding:$K command "handy --toggle-transcription"
gsettings set $S.custom-keybinding:$K binding "<Super>h"
for k in name command binding; do gsettings get $S.custom-keybinding:$K $k; done
'Handy'
'handy --toggle-transcription'
'<Super>h'KDE, Sway, Hyprland도 같은 명령을 각자의 단축키 설정에 넣으면 된다. 녹음 취소는 handy --cancel이다.
LLM 후처리
ctrl+shift+space(또는 --toggle-post-process)로 전사하면 결과를 LLM에 한 번 더 통과시킨다. 기본 프롬프트 “Improve Transcriptions”는 맞춤법·문장부호 교정, 숫자 변환(“twenty-five” → 25), 군말 제거를 하고 원래 언어를 유지하도록 지시한다. 지원 제공자는 소스(settings.rs) 기준으로 다음과 같다.
| 제공자 | 기본 엔드포인트 |
|---|---|
| OpenAI / Anthropic / OpenRouter | 각 서비스 공식 API |
| Groq / Cerebras / Z.ai | 각 서비스 공식 API(OpenAI 호환) |
| AWS Bedrock (Mantle) | OpenAI 호환 엔드포인트 |
| Apple Intelligence | macOS Apple Silicon 전용, 로컬 |
| Custom | http://localhost:11434/v1(Ollama 기본값), 주소 수정 가능 |
음성은 로컬에서 처리되지만 후처리를 켜면 전사된 텍스트는 해당 제공자로 전송된다. 텍스트까지 로컬에 두려면 Custom에 로컬 LLM 서버를 지정한다. 후처리는 API 키와 LLM 서버가 없는 환경이라 실행해 보지 못했고, 위 내용은 소스 기준이다.
주의사항
- 기본 추천 모델은 영어 전용: Parakeet Unified EN에 한국어를 넣으면 에러 없이 로마자 음차를 출력한다. 한국어는 Whisper, SenseVoice, Moonshine Base (Korean), Nemotron Streaming 3.5, Qwen3-ASR 등으로 바꾼다.
- “headless”여도 디스플레이가 필요:
-f,--list-models,--toggle-transcription모두 GTK 초기화를 거친다. 화면이 없으면Failed to initialize gtk backend!로 패닉한다. SSH나 CI에서는xvfb-run을 쓰고, 토글 명령은 실행 중인 인스턴스와 같은DISPLAY에서 보내야 한다.--list-devices는xvfb-run아래에서도 응답 없이 멈췄다. - WAV 형식 제한:
-f는 16kHz 모노 16비트 정수 PCM만 받는다. 다른 형식은 ffmpeg로 변환한다. - 앱 시작 직후 첫 녹음: 실행 중 인스턴스 테스트를 두 번 반복했는데 두 번 모두 시작 직후 첫 녹음에서만 단어가 빠졌다(“ask not what your country do for you, what you can do…”). 두 번째 녹음부터는 정확했다. 모델 로드와 녹음이 겹친 탓으로 보인다. 시작 후 짧게 한 번 말해서 예열해 두는 것이 안전하다.
- 앱 데이터 경로: README는 리눅스 경로를
~/.config/com.pais.handy/로 적고 있지만, 0.9.8 deb 설치 시 실제로는~/.local/share/com.pais.handy/에models/,history.db,recordings/,settings_store.json이 생성됐다. - Wayland 붙여 넣기: 텍스트 입력 도구로 X11은
xdotool, Wayland는wtype(또는dotool/ydotool)이 필요하다. README에 따르면 Ubuntu 26.04 GNOME Wayland에서는wtype이 동작하지 않아ydotool을 써야 한다. 리눅스에서는 녹음 오버레이가 포커스를 빼앗아 붙여 넣기를 망칠 수 있어 기본으로 꺼져 있다. - SIGUSR2는 앱이 완전히 뜬 뒤에: 신호 토글은
SIGUSR2만 처리한다(SIGUSR1은 WebKitGTK가 쓰므로 예전 바인딩에 남아 있다면 지운다). 핸들러가 등록되기 전에 보내면 기본 동작대로 Handy 프로세스가 종료된다. 실제로 실행 후 20초 만에 보냈다가User defined signal 2로 죽었다. 로그(logs/handy.log)에Signal handler registered가 찍힌 뒤에 쓴다. --toggle-transcription이 멈추는 경우: 처음 테스트에서는 두 번 모두 rc=0으로 동작했지만, 이후 반복 테스트에서는 첫 토글만 성공하고 두 번째가 응답 없이 멈추거나(15초 타임아웃) 둘 다 멈추기도 했다. 단축키 연동이 가끔 먹지 않는다면pkill -USR2 -n -x handy를 바인딩하는 편이 안정적이었다.- 녹음 파일 보관: 기본값은 최근 5건의 전사와 원본 WAV를 보관한다(
preserve_limit). 민감한 내용을 말한다면recording_retention_period를never로 바꾼다.
마무리
Handy는 “단축키 하나로 받아쓰기”라는 한 가지 일을 로컬에서 하는 도구다. GPU 없는 6코어 VM에서도 SenseVoice는 한국어를 실시간의 6배 속도로 처리했다. 한국어로 쓴다면 설치 직후 모델부터 바꾸고, 리눅스라면 데스크톱 단축키에 handy --toggle-transcription을 바인딩하는 것으로 시작하면 된다. -f 모드는 내 목소리와 마이크 환경에서 어떤 모델이 맞는지 비교할 때 유용하다.